
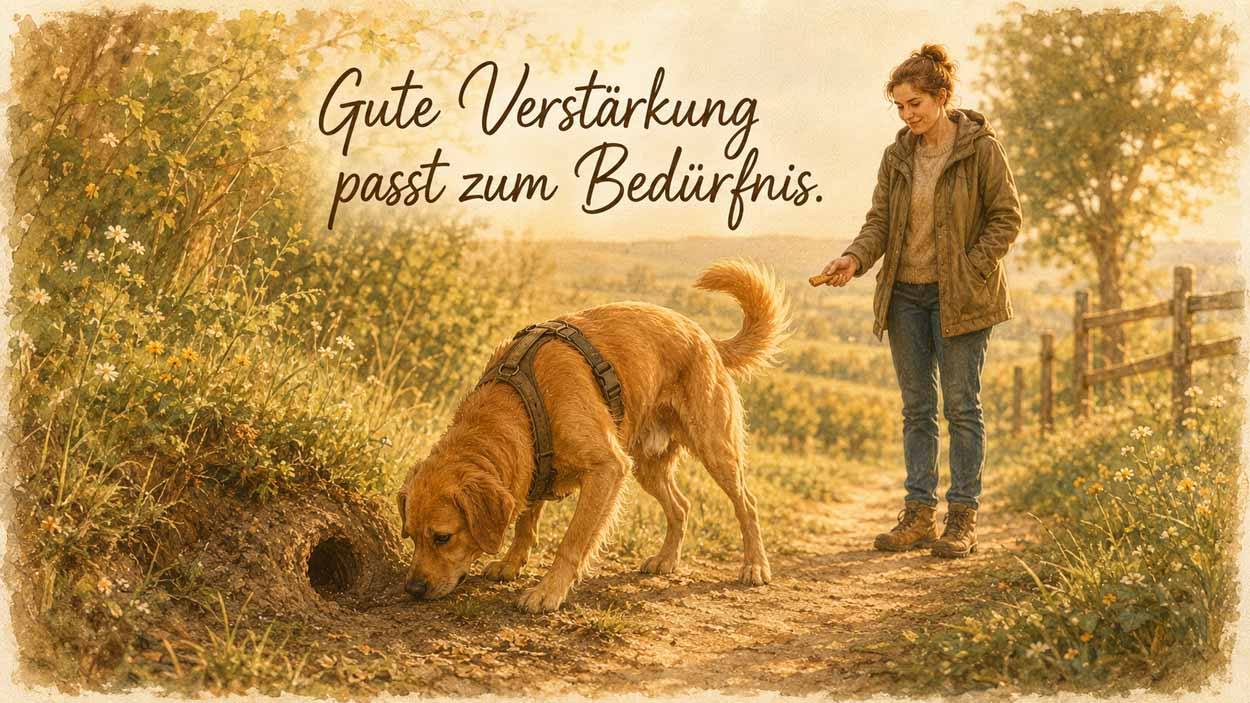
Wenn die Belohnung genau das ist, was der Hund wirklich will
Timmy buddelt am Wegesrand, ganz und gar vertieft in sein Mäuseloch. Die Bezugsperson gibt das Signalwort: „Schau.“ Daraufhin unterbricht Timmy sein Buddeln und blickt zu ihr auf – eine echte Meisterleistung, wenn man bedenkt, wie sehr das Mäuseloch gerade um seine Aufmerksamkeit konkurriert! Sie raschelt mit der Leckerchentüte und hält ihm einen Keks hin. Doch statt zuzugreifen, blickt Timmy sie weiter an.
Was ist hier passiert? Timmy hat eigentlich alles richtig gemacht: Er hat auf das Signal reagiert und den Blickkontakt hergestellt. Nur die angebotene Belohnung hat nicht gepasst – in diesem Moment ist das Mäuseloch für ihn schlicht attraktiver als die halbe Kuh auf Toast, die ihm die Bezugsperson anbietet.
Klüger als hartnäckig beim Keks zu bleiben: Die Bezugsperson gibt Timmy – sofern gefahrlos möglich – die Erlaubnis, mit dem weiterzumachen, was er vorher getan hat. Ein kurzes „Ja, mach weiter“ genügt, und Timmy widmet sich wieder seinem Loch. Damit hat die Bezugsperson genau richtig reagiert: Sie hat erkannt, dass der Keks in diesem Kontext keine Belohnung war – während das Weiterbuddeln-Dürfen für Timmys kurze Unterbrechung und seinen Blickkontakt genau die passende Belohnung ist.
Genau hier setzen funktionale Verstärker an. Sie fragen nicht „Was habe ich anzubieten?“, sondern „Was will der Hund in diesem Moment eigentlich?“ – und genau das wird zur Belohnung.
Was ist ein Verstärker überhaupt?
Bevor du tiefer in Timmys Geschichte einsteigst, kurz zur Basis: Ein Verstärker ist in der Lerntheorie jede Konsequenz, die dafür sorgt, dass ein Verhalten in Zukunft wahrscheinlich häufiger gezeigt wird. Timmy buddelt mehr, weil Buddeln sich für ihn lohnt – so einfach ist das Prinzip im Kern.
Man unterscheidet zwei Grundtypen:
- Primäre Verstärker befriedigen angeborene Bedürfnisse unmittelbar – Futter, Wasser, sozialer Kontakt, Bewegung.
- Sekundäre (konditionierte) Verstärker kündigen einen primären Verstärker lediglich an, etwa ein Markerwort oder der Klick eines Clickers. Sie funktionieren wie eine Quittung: „Das war’s – deine Belohnung ist unterwegs.“
Das zugrunde liegende Prinzip nennt sich operante Konditionierung: Timmy verknüpft sein eigenes Verhalten mit dessen Folgen und passt sein Verhalten entsprechend an. Er lernt nicht, weil wir es ihm erklären, sondern weil sich Buddeln für ihn ganz praktisch lohnt.
Damit man dieses Zusammenspiel systematisch betrachten kann, hat sich in der Verhaltensanalyse ein einfaches Dreierschema bewährt – das ABC-Schema:
- A – Antecedent (Auslöser): Was ist unmittelbar vor dem Verhalten passiert? Timmy entdeckt frische Erde und einen verheißungsvollen Geruch.
- B – Behavior (Verhalten): Was tut der Hund konkret? Timmy buddelt.
- C – Consequence (Konsequenz): Was folgt daraus – und verstärkt das Verhalten? Der Erdgeruch wird intensiver, es raschelt vielleicht sogar im Loch – die Aussicht, die Maus gleich zu erwischen, rückt näher. Genau das verstärkt das Buddeln, nicht das Buddeln an sich.
Werfen wir dasselbe Schema noch einmal auf die Szene vom Anfang – nur diesmal auf das, was zwischen Bezugsperson und Timmy passiert:
- A – Antecedent: Die Bezugsperson gibt das Signalwort „Schau“.
- B – Behavior: Timmy unterbricht das Buddeln und blickt zu ihr auf.
- C – Consequence (also die Belohnung): Zunächst bietet die Bezugsperson einen Keks an – Timmy nimmt ihn nicht, sondern blickt sie weiter an. Als zweite Option bietet die Bezugsperson ihm die Möglichkeit, mit dem weiterzumachen, was er vorher getan hat: dem Buddeln. Diese zweite, passende Konsequenz ist es, die Timmys „Schau“ tatsächlich verstärkt – nicht der ungenutzte Keks.
Wichtig dabei: Timmys Verhalten war von Anfang an völlig richtig – er hat auf das Signal reagiert, das Buddeln unterbrochen und den Blickkontakt hergestellt. Was zunächst nicht gepasst hat, war die gewählte Konsequenz (also die Belohnung). Und das ist überhaupt kein Drama: Dass eine erste Belohnung nicht angenommen wird, ist kein Trainingsfehler, sondern ganz normaler Trainingsalltag. Die Bezugsperson musste hier nicht von Anfang an die „richtige“ Belohnung erraten – sie musste nur flexibel genug sein, die Situation kurz einzuschätzen und binnen weniger Sekunden nachzujustieren.
Ein „Fehlversuch“ ist dabei nichts anderes als eine Information: Er zeigt lediglich, dass etwas in diesem Moment so nicht funktioniert hat, wie erwartet – mehr nicht. Leben heißt lernen, und lernen heißt zwangsläufig auch mal daneben zu liegen. Kein Drama also, sondern Alltag. Und je länger du dich mit dem Verhalten deines Hundes befasst und nach passenden funktionalen Verstärkern suchst, desto treffsicherer und schneller wirst du im Alltag die richtige Option finden – ganz ohne perfekt starten zu müssen. (Wie wichtig es trotzdem ist, diese Anpassung zügig vorzunehmen, schauen wir uns weiter unten beim Thema Timing genauer an.)
Timmy buddelt im Übrigen auch nicht um des Buddelns willen. Das Buddeln ist nur das Mittel zum Zweck – der eigentliche Grund, warum es sich für ihn lohnt, ist die Chance, die Maus zu fangen. Diesen Unterschied zwischen dem sichtbaren Verhalten und seiner eigentlichen Funktion brauchst du gleich wieder, wenn es um funktionale Verstärker geht.
Was einen Verstärker „funktional“ macht (Premack-Prinzip)
Diesen Unterschied zwischen Verhalten und Funktion kannst du jetzt gleich nutzen. Denn genau hier kommt der Begriff „funktionaler Verstärker“ ins Spiel. Ein funktionaler Verstärker – auch bedürfnisbefriedigender Verstärker genannt – ist eine Belohnung, die dem tatsächlichen Bedürfnis des Hundes im jeweiligen Moment so nah wie möglich kommt, statt es nur zu übertönen. Bei Timmy wäre das: weiterbuddeln, weitersuchen, der Maus näherkommen dürfen. Nicht die halbe Kuh auf Toast.
Wissenschaftlich lässt sich das Prinzip auf den Psychologen David Premack zurückführen, der 1965 die sogenannte „differential probability hypothesis“ formulierte – heute meist kurz als Premack-Prinzip bezeichnet. Vereinfacht gesagt: Verhaltensweisen, die ein Tier mit hoher Wahrscheinlichkeit ohnehin zeigen würde, können als Verstärker für Verhaltensweisen mit niedrigerer Wahrscheinlichkeit eingesetzt werden. Übersetzt auf Timmy: Buddeln-dürfen (hohe Wahrscheinlichkeit, wenn man ihn ließe) kann eingesetzt werden, um ruhiges Sitzen oder Zuwendung (niedrigere Wahrscheinlichkeit im Moment der Maus-Erregung) zu verstärken – vorausgesetzt, man dreht die Reihenfolge geschickt um: erst kurz herschauen, dann weiterbuddeln dürfen.
Für Nerds: In der Terminologie der Applied Behavior Analysis (ABA) spricht man hier von einer motivating operation – einem Zustand, der den Wert eines bestimmten Reizes als Verstärker in genau diesem Moment erhöht. Ein funktionaler Verstärker ist also kontextabhängig: Dasselbe Mäuseloch, das jetzt hochattraktiv ist, wird für Timmy bedeutungslos, sobald die Maus längst geflüchtet ist – dann zieht plötzlich wieder die halbe Kuh auf Toast.
Kurz gesagt: Wer verstehen will, warum ein Hund gerade nicht reagiert, sollte weniger fragen „Was biete ich an?“ und mehr „Was will er gerade wirklich?“ Bei Timmy war die Antwort eindeutig – und lag buchstäblich im Loch.
Warum das mehr ist als eine nette Idee (Friedman und die funktionale Verhaltensanalyse)
Timmys Mäuseloch ist ein Beispiel – aber was passiert, wenn ein Hund unerwünschtes Verhalten zeigt: er bellt, er zieht an der Leine oder springt Menschen an? Auch hier lohnt sich derselbe Blick: nicht auf das Verhalten selbst starren, sondern nach seiner Funktion fragen. Genau diesen Ansatz hat die Verhaltensbiologin Susan Friedman über Jahrzehnte hinweg für den Umgang mit Tieren etabliert – die sogenannte funktionale Verhaltensanalyse (Functional Behavior Assessment, kurz FBA).
Friedmans zentraler Gedanke: Verhalten passiert nie im luftleeren Raum, sondern steht immer in einer Wechselbeziehung mit der Umwelt – genau das beschreibt ja auch das ABC-Schema, das du gerade kennengelernt hast. Bevor man ein Verhalten verändern will, muss man zuerst verstehen, welches Bedürfnis es befriedigt. Bei Timmy war das offensichtlich: Buddeln führt (potenziell) zur Maus. Bei einem Hund, der Besuch an der Tür anspringt, ist die Funktion oft eine ganz andere, aber ebenso nachvollziehbare: Aufmerksamkeit und sozialer Kontakt.
Wie praxisrelevant dieser Gedanke ist, zeigt eine im Fachjournal Animals veröffentlichte Studie zum Hochspringen bei Hunden. Statt das Verhalten schlicht zu unterdrücken, wurde zunächst seine Funktion identifiziert – meist eben jener Wunsch nach Nähe und Aufmerksamkeit – und anschließend ein alternatives Verhalten aufgebaut, das mit demselben, funktional passenden Verstärker belohnt wurde. Der Hund lernte also nicht nur „Nicht springen“, sondern gleichzeitig ein Verhalten, das ihm zuverlässig zu genau dem verhalf, was er ohnehin wollte.
Der entscheidende Unterschied zur reinen Symptombekämpfung: Wird nur das unerwünschte Verhalten unterdrückt, ohne die zugrunde liegende Funktion zu berücksichtigen, bleibt das Bedürfnis unbefriedigt – und meldet sich häufig auf anderem Weg zurück. Wird hingegen die Funktion erkannt und über einen passenden funktionalen Verstärker bedient, verschwindet das Problem oft nicht nur an der Oberfläche, sondern nachhaltig.
Für Nerds: Friedmans FBA unterscheidet typischerweise drei Vorgehensweisen: die indirekte Einschätzung (Fragebögen, Interviews), die deskriptive Beobachtung (Verhalten ohne Manipulation der Umgebung beobachten) und die eigentliche funktionale Analyse (systematische Veränderung von Antezedenzien und Konsequenzen, um die Funktion experimentell zu bestätigen). Für den Trainingsalltag reicht meist schon der erste Schritt – ein bewusster Blick durchs ABC-Schema – um handlungsfähig zu werden.
Der Blick aufs Tierwohl
Warum ist es eigentlich so wichtig, Timmy sein Mäuseloch zu lassen, statt ihn mit Futter oder einer möglichen anderen Belohnung „umzustimmen“? Du hast schließlich nicht nur Futter im Angebot, sondern noch ganz viele andere tolle Belohnungen im Köcher, die du deinem Hund als Option anbieten kannst – genau wie bei Timmys Mäuseloch geht es darum, die passende Option zu finden. Die Antwort, warum das so wichtig ist, liegt nicht nur in der Lerntheorie, sondern auch im Tierwohl.
Das sogenannte Fünf-Domänen-Modell, ein in der Tierwohlforschung etabliertes Rahmenwerk, beschreibt fünf Bereiche, die das Wohlbefinden eines Tieres bestimmen: Ernährung, Umgebung, Gesundheit, Verhaltensinteraktionen – und, als Ergebnis der ersten vier, den mentalen Zustand des Tieres.
Neuere Weiterentwicklungen des Modells rücken einen Aspekt besonders in den Fokus: die sogenannte Agency – die Möglichkeit eines Tieres, selbstbestimmt zu handeln und aktiv Einfluss auf sein Umfeld zu nehmen. Und genau das ist es, was Timmys Mäuseloch so wertvoll für ihn macht: Es ist nicht einfach ein angenehmer Reiz, sondern eine Gelegenheit, selbst aktiv zu werden, zu erkunden, zu entscheiden. Diese Selbstwirksamkeit lässt sich durch keinen noch so großen Batzen Kuh auf Toast ersetzen.
Wie stark dieser Drang zur Eigenaktivität tatsächlich ist, zeigt ein Phänomen namens Kontrafreeloading: Viele Tierarten – Ratten, Vögel, Wölfe und eben auch Hunde – arbeiten nachweislich lieber für ihr Futter, als es sich einfach und ohne Aufwand zu schnappen, sofern der nötige Aufwand nicht zu groß ist. Eine 2024 im Fachjournal Scientific Reports veröffentlichte Studie bestätigte dieses Verhalten erstmals systematisch bei Haushunden: Zwar zeigten die Hunde keine grundsätzliche Vorliebe fürs „Arbeiten“ gegenüber frei zugänglichem Futter, waren aber bereitwillig dazu, sobald ihnen eine Futtersuche angeboten wurde. Timmy hätte diese Studie vermutlich nicht gebraucht, um es zu bestätigen – sein Mäuseloch sagt eigentlich schon alles.
Nicht zu verwechseln mit Kontrafreeloading ist die therapeutische Futtersuche – ein Konzept, das gezielt in der Verhaltensberatung eingesetzt wird. Anders als beim Kontrafreeloading geht es hier nicht um eine allgemeine Arbeitspräferenz, sondern um eine bewusst druckfreie, erwartungslose Suchsituation ohne Leistungsziel. Das Besondere daran: Sie eignet sich für jeden einzelnen Hund – ganz unabhängig davon, mit welchem Label er behaftet sein mag, ob „ängstlich“, „aggressiv“ oder irgendein anderes. Somit ist sie für jeden Hund ein Werkzeug, um Selbstwirksamkeit und innere Ruhe aufzubauen, statt „nur“ Beschäftigung zu bieten.
Für Nerds: Die Forscher:innen hinter der Kontrafreeloading-Studie führen dieses Verhalten auf das sogenannte „Information-Primacy-Modell“ zurück: Demnach ist die aktive Suche nach Informationen über die Umwelt für Tiere evolutionär von Vorteil und daher selbst verstärkend – unabhängig vom eigentlichen Ergebnis der Suche. Schnüffeln, Erkunden und Absuchen sind aus dieser Perspektive also nicht bloß Mittel zum Zweck, sondern ein Bedürfnis für sich. Das erklärt übrigens auch, warum viele Hunde beim Spaziergang eher an der Nase als am Tempo interessiert sind – frei nach dem Motto: Der Weg ist das Ziel, solange es dabei irgendwo verheißungsvoll riecht.
Info-Kasten: Funktionale Verstärker nach Bedürfniskategorie
| Bedürfnis des Hundes | Funktionaler Verstärker (Beispiele) |
|---|---|
| Geruchsbezogene Informationssuche | Weiterschnüffeln dürfen, Suchspiel, Fährtenarbeit fortsetzen |
| Jagd-/Beutemotivation | Kurzes Hetzspiel mit Ersatzobjekt, Zerrspiel, Futterbeutel jagen |
| Sozialkontakt (Hund) | Freigabe zum Spiel mit Artgenossen |
| Sozialkontakt (Mensch) | Zuwendung, gemeinsames Spiel, Körperkontakt (falls gewünscht) |
| Bewegungsdrang | Freilauf, Rennen dürfen, Tempo selbst wählen |
| Ruhe- und Rückzugsbedürfnis | Zugang zu einem ungestörten Rückzugsort |
| Kontrolle/Selbstwirksamkeit | Eigenständige Entscheidung über Weg, Tempo oder Annäherung |
Timmys Fall lässt sich hier klar einordnen: „Geruchsbezogene Informationssuche“ – sein funktionaler Verstärker ist das Weiterbuddeln, nicht der Keks.
Verstärker klug einsetzen
Timmys Geschichte mit dem Mäuseloch hat schon gezeigt: Wissen, wofür man einen Hund belohnt, ist die eine Sache – wissen, wie man das am geschicktesten tut, eine andere. Die Bezugsperson hat bei Timmy binnen weniger Sekunden nachjustiert und die passende Belohnung gefunden. Das war kein Zufallstreffer, sondern lässt sich lernen – und genau darum geht es jetzt.
Denn selbst wenn du die Funktion eines Verhaltens längst erkannt hast, bleiben im Trainingsalltag noch zwei entscheidende Fragen offen: Wie belohnst du am wirkungsvollsten? Und wann, wie oft, wie viel? Beide Fragen hängen eng zusammen, verdienen aber jeweils einen eigenen Blick.
Wie belohnt wird
Abwechslung statt Dauerkeks. Belohnungen dürfen – und sollen – variieren: mal ein Stück Käse, mal ein kurzes Spiel, mal eine Runde Schnüffeln, mal ein anerkennendes „Ja, genau so!“ mit warmer Stimme. Ein Grund dafür ist die sogenannte Sättigung: Wird derselbe Verstärker immer wieder in kurzer Folge angeboten, verliert er an Wert – so, wie das fünfte Stück Schokolade weniger verlockend ist als das erste. Abwechslung hält die Motivation frisch und macht Training gleichzeitig lebendiger – für deinen Hund und für dich.
Die eigene Stimme, das eigene Gesicht. Nicht jeder Verstärker muss materiell sein. Tonfall, Mimik und Körpersprache der Bezugsperson selbst sind hochwirksame, oft unterschätzte Verstärker – ein ehrlich gemeintes, freudiges „Fein gemacht!“ kann für einen aufmerksamen Hund genauso viel wert sein wie ein Leckerli, besonders wenn diese soziale Rückmeldung verlässlich mit guten Dingen verknüpft ist. Auch ein freundlich lächelndes Gesicht darf durchaus mal die Belohnung sein – Hunde erkennen unsere Mimik und reagieren nachweislich auf unterschiedliche menschliche Gesichtsausdrücke.
Strukturiertes verbales Lob. Eine besondere Form der stimmlichen Belohnung ist das sogenannte strukturierte verbale Lob (SVL). Es funktioniert wie jedes andere Markersignal auch: Ein Markerwort – zum Beispiel „Bingo“ – kündigt die Belohnung an, gefolgt von einer feststehenden, immer gleichen Lobformel, etwa „Super, Burschi!“ Das Besondere: SVL besteht ausschließlich aus Worten, ohne dass im Anschluss noch ein Keks oder Spielzeug folgt. Für Timmy bedeutet das: Sobald er dieses spezielle Lob hört, weiß er zweifelsfrei zweierlei – dass er genau das, wofür er gerade gelobt wurde, richtig gemacht hat, und dass jetzt nichts weiter folgt. Diese doppelte Klarheit mag zunächst unspektakulär klingen, ist aber wertvoll – sie schenkt Erwartungssicherheit, und genau die ist im Training essenziell.
Belohnung ist Kommunikation, keine Überredung. Ein wichtiger gedanklicher Unterschied: Überredung bedeutet, jemanden vorab mit einer Belohnung zu einer Handlung zu bewegen – etwa beim Locken, wo die Belohnung sichtbar vor die Nase gehalten wird, um ein Verhalten überhaupt erst auszulösen. Verstärkung dagegen folgt dem Verhalten und teilt dem Hund im Nachhinein mit: „Das war goldrichtig.“ Der Keks kommt nicht, damit Timmy etwas tut – das wäre Locken. Er kommt, weil Timmy etwas getan hat. Diese Reihenfolge macht den ganzen Unterschied zwischen Überredung und fairer, verständlicher Kommunikation.
Wann und wie viel belohnt wird
Nie leer ausgehen. Ein sicher gezeigtes, erwünschtes Verhalten verdient immer eine positive Rückmeldung – mindestens das SVL. Das ist kein netter Bonus, sondern trainingsrelevant: Wird ein Verhalten als selbstverständlich hingenommen und bleibt die Rückmeldung irgendwann ganz aus, verliert es für den Hund an Wert – und wird in der Folge seltener gezeigt. Abwechslung in der Belohnungsart heißt also ausdrücklich nicht: manchmal gar nichts. Es bedeutet: Die Art der Belohnung variiert, das Feedback selbst bleibt immer bestehen.
Timing ist alles. Damit dein Hund sein eigenes Verhalten mit der Konsequenz verknüpfen kann, muss die Rückmeldung so präzise wie möglich erfolgen – im besten Fall im Moment des Verhaltens selbst, nicht erst eine Minute später, wenn er längst etwas anderes tut. Genau hier zeigt sich der Wert eines gut konditionierten Markersignals, wie du es von Timmys „Bingo“ schon kennst: Ein Klick oder ein Markerwort im exakt richtigen Moment sagt deinem Hund „Genau das war’s!“ – noch bevor die eigentliche Belohnung überhaupt eintrifft. Das Markersignal übernimmt damit gleich zwei Aufgaben auf einmal: Es liefert das perfekte Timing, weil es genau im richtigen Moment gegeben wird – und es verschafft dir gleichzeitig ein paar Sekunden Zeit, in Ruhe zu überlegen, welche Belohnung in diesem konkreten Moment tatsächlich passt.
Der Wert eines Verstärkers ist situationsabhängig. Dasselbe Stück Käse, das zu Hause zuverlässig funktioniert, kann draußen mit einem frischen Mäuseloch in der Nähe komplett wirkungslos verpuffen. Das liegt nicht daran, dass dein Hund „stur“ wäre, sondern schlicht daran, dass sich sein aktueller Bedürfniszustand in diesem Moment verändert hat: Ist er gerade satt oder hungrig, abgelenkt oder fokussiert, aufgeregt oder entspannt? All das entscheidet mit, wie viel ein bestimmter Verstärker gerade wert ist – und dieser Wert kann sich von einer Minute zur nächsten verschieben. Genauso spielt eine Rolle, was dein Hund an diesem Tag bereits geleistet hat: Ein Hund, der schon einen ereignisreichen Vormittag hinter sich hat, bewertet dieselbe Belohnung womöglich ganz anders als einer, der ausgeruht in den Tag gestartet ist.
Verstärkerpläne: erst engmaschig, dann großzügig. Beim Aufbau eines neuen Verhaltens lohnt es sich, zunächst jedes Mal zu verstärken – so entsteht eine verlässliche Verknüpfung. Ist das Verhalten stabil, kann auf unregelmäßige Verstärkung umgestellt werden. Wichtig: Das betrifft die materielle Belohnung – das SVL oder ein anderes positives Feedback bleibt davon unberührt und wird weiterhin bei jeder Ausführung gegeben. Verhalten, das nur gelegentlich, aber unvorhersehbar mit einer „großen“ Belohnung bedacht wird, ist erwiesenermaßen widerstandsfähiger gegen gelegentliches Ausbleiben dieser Belohnung als Verhalten, das immer nur nach festem Muster belohnt wurde.
Nicht raten, sondern testen. Was für deinen Hund gerade der wertvollste Verstärker ist, muss nicht angenommen, sondern kann kurz beobachtet werden: Biete ihm zwei Optionen gleichzeitig an (z. B. Käse vs. kurzes Zerrspiel) und beobachte, wofür er sich entscheidet. Solche kleinen, informellen Präferenztests ersetzen Vermutungen durch echte Information.
Für Nerds: In der Fachsprache spricht man bei diesen Belohnungsmustern von Verstärkerplänen (reinforcement schedules). Kontinuierliche Verstärkung (jedes Mal) eignet sich besonders für den Aufbau neuen Verhaltens, während intermittierende, insbesondere variable Verstärkerpläne (unregelmäßig, aber im Schnitt vorhersehbar) ein Verhalten deutlich löschungsresistenter machen – ein Effekt, der aus der Lernpsychologie als „Partial Reinforcement Extinction Effect“ bekannt ist. Wichtig dabei: Intermittierende Verstärkung sollte erst eingeführt werden, wenn das Zielverhalten bereits zuverlässig gezeigt wird – zu früh eingesetzt, kann sie Frustration statt Stabilität erzeugen.
Praxisbeispiele je Bedürfniskategorie
Genug Theorie – wie sieht das Ganze jetzt im Alltag aus? Hier ein paar Beispiele, sortiert nach Bedürfniskategorie, die zeigen, wie sich funktionale Verstärker in ganz unterschiedlichen Situationen einsetzen lassen.
Geruchsbezogene Informationssuche. Timmy lässt grüßen: Ein Hund, der mitten im Schnüffeln unterbrochen und dafür belohnt werden soll, profitiert am meisten davon, weiterschnüffeln zu dürfen – ob am eigenen Mäuseloch oder bei einer kurzen Fährtenübung. Ein Keks kann hier durchaus als zusätzliches Sahnehäubchen funktionieren, ersetzt aber selten das eigentliche Bedürfnis.
Jagd-/Beutemotivation. Ein Hund, der einem Hasen hinterherjagen möchte, lässt sich selten zuverlässig mit Futter allein abrufen – die Jagdmotivation ist in diesem Moment schlicht stärker. Wirksamer: ein alternatives, ebenfalls hochmotivierendes Jagdersatzverhalten aufbauen, etwa das gezielte Hetzen eines Zugballs, und genau dieses als Belohnung für den Rückruf einsetzen. So lernt der Hund: Kommen zahlt sich mit derselben Art von Erregung aus, die er ohnehin gesucht hat.
Sozialkontakt mit der Bezugsperson. Manche Hunde suchen in bestimmten Momenten weniger Futter als schlicht Nähe: ein kurzes Kraulen, ein gemeinsames Sich-Hinsetzen, ein paar Worte in warmem Tonfall. Gerade bei unsicheren oder sensiblen Hunden kann diese Form der Zuwendung wertvoller sein als jeder Keks – und ist gleichzeitig ein schönes Beispiel dafür, wie eng „Die eigene Stimme, das eigene Gesicht“ (siehe oben) und funktionale Verstärkung zusammenhängen.
Ruhe- und Rückzugsbedürfnis. Ein überreizter oder erschöpfter Hund wird durch noch mehr Aktion nicht belohnt, sondern durch Zugang zu einem ruhigen, ungestörten Rückzugsort. Gerade nach stressigen Erlebnissen ist so eine Decompression-Phase oft die eigentlich passende „Belohnung“ – auch wenn sie auf den ersten Blick nicht wie eine aussieht.
Kontrolle und Selbstwirksamkeit. Die wertvollste Belohnung überhaupt ist häufig die Möglichkeit, selbst entscheiden zu dürfen. Diese Form von Selbstwirksamkeit solltest du deinem Hund so oft wie möglich ermöglichen – selbstverständlich mit einem wachen Auge auf die Sicherheit: Entscheidet sich dein Hund beispielsweise dafür, ein Reh zu hetzen, wird diese Option aus guten Gründen natürlich nicht ermöglicht.
Im Alltag heißt das oft: selbst wählen dürfen, welchen Weg man einschlägt, wie schnell man geht, ob man sich einem neuen Reiz nähert oder lieber Abstand hält. Diese Form von Agency (siehe „Der Blick aufs Tierwohl“ weiter oben) lässt sich nicht kaufen, aber gezielt ermöglichen – und ist oft die stärkste Form von Wertschätzung, die eine Bezugsperson einem Hund entgegenbringen kann.
Diese fünf Beispiele stehen exemplarisch für viele weitere: Ganz gleich, um welches Verhalten es geht – der Blick auf das dahinterliegende Bedürfnis lohnt sich immer. Wir sehen letztlich immer nur das Verhalten unseres Hundes und müssen daraus schließen, welches Bedürfnis sich dahinter verbirgt. Genau das ist das A und O eines fairen und freundschaftlichen Umgangs mit dem Hund.
Vom funktionalen Verstärker zur natürlichen Konsequenz
Ein letzter Gedanke, bevor der Artikel zu Ende geht: Am Anfang musst du gutes Verhalten noch bewusst belohnen – mit Keks, Lob oder eben genau der passenden funktionalen Belohnung. Zeigt dein Hund dieses Verhalten aber immer wieder zuverlässig, merkst du irgendwann: Du musst gar nicht mehr jedes Mal aktiv nachhelfen. Das Leben selbst belohnt ihn plötzlich mit – ganz automatisch.
Ein Beispiel: Bleibt dein Hund zuverlässig ruhig, wenn ihr anderen Hunden begegnet, merkt er mit der Zeit von ganz allein: Ruhe bringt ihm mehr Freiheiten – mehr Vertrauen, mehr Freiraum, entspanntere Spaziergänge. Du musst das nicht mehr jedes Mal extra belohnen, es passiert einfach.
Bevor es aber überhaupt so weit kommt, lohnt sich noch ein anderer, wichtiger Gedanke: Warum unterbrichst du ein Verhalten eigentlich, das dein Hund gerade zeigt? Für Timmy war es eine echte Meisterleistung, sein Buddeln zu unterbrechen – er hat etwas für ihn sehr Lohnendes aufgegeben, nur weil du ihn darum gebeten hast. Das ist nichts Selbstverständliches. Deshalb lohnt sich vor jeder Unterbrechung die kurze Frage: Muss das jetzt wirklich sein – oder kann ich meinem Hund seinen Moment einfach lassen?
Fazit
Zurück zu Timmy und seinem Mäuseloch: Sein Verhalten – den Keks nicht anzunehmen und stattdessen seine Bezugsperson weiter anzuschauen – zeigt sehr anschaulich, worum es bei funktionalen Verstärkern eigentlich geht. Timmy hatte in diesem Moment schlicht keine Freude an dem angebotenen Keks und somit auch keine echte Belohnung erhalten. Die passende Belohnung für seinen Blickkontakt war eine ganz andere: „Okay, du darfst weiterbuddeln!“
Genau das ist der Kern funktionaler Verstärker: Es geht nie um die – in Anführungszeichen – „bessere“ Belohnung, sondern immer um die passende. Und wir sollten es unserem Hund niemals übelnehmen, wenn er eine angebotene Belohnung nicht annehmen kann. Belohnungen sind schließlich immer nur Optionen, die wir anbieten – keine Garantien. Genau deshalb lohnt es sich, ein möglichst vielfältiges Repertoire an Belohnungsmöglichkeiten zu etablieren.
Manchmal ist die passende Belohnung ein Keks. Manchmal eine ruhige Streicheleinheit. Manchmal ist es, Abstand zu schaffen und Kontakt zu einem Auslöser zu vermeiden. Manchmal ein Spiel mit dem Ball – und manchmal einfach, sich gemeinsam auf eine Wiese zu setzen und zu beobachten, was um einen herum passiert.
Es liegt immer an uns, die passende Belohnung und damit den passenden Verstärker für unseren Hund im jeweiligen Kontext zu finden. Das ist gar nicht schwierig, wenn wir uns darauf einlassen, ein Stück weit in seine Welt einzutauchen. Wir schauen auf das Verhalten unseres Hundes und erkennen daraus, was sein wirkliches Bedürfnis in diesem Moment ist – und genau dieses Bedürfnis sollten wir täglich so gut wie möglich befriedigen, natürlich immer im Rahmen des Möglichen.
Das Hetzen von Wild, Joggern oder Radfahrern ist selbstverständlich niemals erlaubt – hier sorgen wir stattdessen für eine passende Alternative. Ein alter Hund, dem die Gelenke schmerzen und der trotzdem gerne buddeln würde, wird nicht auf einem harten Acker graben müssen – hier reicht oft schon ein kleiner Sandkasten im Garten als liebevolle Alternative. Für nahezu jedes Bedürfnis lässt sich eine passende Alternative finden, wenn wir uns nur darauf einlassen.
Quellen
Wissenschaftliche Grundlagenliteratur
- Premack, D. (1965). Reinforcement theory. In D. Levine (Hrsg.), Nebraska Symposium on Motivation. University of Nebraska Press.
- Friedman, S. G. (2007). A Framework for Solving Behavior Problems: Functional Assessment and Intervention Planning. Journal of Exotic Pet Medicine, 16(1), 6–10.
- Friedman, S. G. (2009). Functional Assessment: Hypothesizing Predictors and Purposes of Problem Behavior to Improve Behavior-Change Plans. APDT Journal, September 2009. www.behaviorworks.org
- Using Principles from Applied Behaviour Analysis to Address an Undesired Behaviour: Functional Analysis and Treatment of Jumping Up in Companion Dogs. Animals. PMC6940775.
Tierwohl und Bedürfnisforschung
- Littlewood, K. E., & Mellor, D. J. (2016). Changes in the Welfare of an Injured Working Farm Dog Assessed Using the Five Domains Model. Animals, 6(9), 58. https://doi.org/10.3390/ani6090058
- The agency domain and behavioral interactions: assessing positive animal welfare using the Five Domains Model. Frontiers in Veterinary Science, 2023.
- Domestic pet dogs (Canis lupus familiaris) do not show a preference to contrafreeload, but are willing. Scientific Reports, 2024. https://www.nature.com/articles/s41598-024-51663-x
Trainingsmethodik und Wirksamkeit positiver Verstärkung
- Hiby, E. F., Rooney, N. J., & Bradshaw, J. W. S. (2004). Dog training methods: their use, effectiveness and interaction with behaviour and welfare. Animal Welfare, 13(1), 63–69.
- Deldalle, S., & Gaunet, F. (2014). Effects of 2 training methods on stress-related behaviors of the dog and on the dog–owner relationship. Journal of Veterinary Behavior, 9(2), 58–65.
- Partial rewarding and affective state in clicker-trained dogs. Animal Cognition, 2020. https://doi.org/10.1007/s10071-020-01425-9
Weiterführende Literatur
- Friedman, Dr. Susan G. – Referentenprofil und Webinare zu funktionaler Verhaltensanalyse (ABA) bei Tieren: https://www.dog-ibox.com/de/speaker/dr-susan-g-friedman.html